Velocity – Eine Einführung
Velociwas? Codenamen sind bei Microsoft, seit ich diese Firma kenne, Bestandteil der Firmenkultur und werden vermutlich so schnell nicht verschwinden. Mittlerweile würde ich mir wünschen von den Codenamen wegzukommen. Es verwirrt mich einfach schon selbst bei der Fülle von Technologien die wir erstellen, den Codenamen jeweils der richtigen zuzuordnen.
Velocity ist ein “Distributed Cache”. Oder auf Deutsch: Velocity ist ein “Verteilter Zwischenspeicher”. Ein Zwischenspeicher der logisch mehrere physikalische Maschinen zu einem einheitlichen Cache verschmelzen lässt. Die Velocity Infrastruktur sorgt hierbei das die Daten im Verbund für alle verfügbar sind und bei Bedarf auch noch repliziert werden.
Wann setzt man Caching ein, wann macht es Sinn Daten nicht direkt aus der eigentlichen Datenquelle zu lesen und dementsprechend vorzuhalten?
Wir benutzen in der Anwendung von Technologien öfters Cache-Systeme und Mechanismen als uns bewußt ist. Dies passiert meist implizit, ohne das wir davon viel mitbekommen. Ein Beispiel ist das Dateisystem. Das Dateisystem speichert die Zugriffe in einen Zwischenspeicher und ermöglicht so eine bessere Performance beim lesen und auch schreiben der Daten. Der Durchsatz wird erhöht und Fesplatten profitieren von dem Lese/Schreibcache.
Wenn man Caching in seine eigene Anwendung einbauen möchte, so möchte man in der Regel die Performance steigern. Das ist oft dann notwendig wenn die Architektur der Anwendung Mehrschichtig ist und die Schichten auch physikalisch in unterschiedlichen Prozessen (oder auch Maschinen) liegen. Nur dann? Nein, das kann ebenfalls Sinn machen wenn es sich um eine Anwendung handelt die Intensive Operationen auf eine Datenquelle (nicht zwangsläufig eine Datenbank) durchführt und diese Operation jedesmal zusätzlich Zeit kostet. Hier bietet es sich auch an die Daten aus der Quelle im Speicher der Anwendung vorzuhalten.
Vielleicht benutzt der ein oder andere für bestimmte Daten schon ein disconnected DataSet in welchem Lookup Daten im Prozess gehalten werden. Das ist im Prinzip auch ein Cache. Allerdings keiner der sich mit anderen Zwischenspeichern synchronisieren kann. Ich habe Lookup Daten erwähnt. Ein Cache ist also nicht für jede Art von Daten Sinnvoll. Welche machen denn Sinn?
Referenz Daten
Bleiben wir doch bei den Lookup Daten. Es sind sogenannte Referenz-Daten. Referenz-Daten sind z.B. Katalog-Daten, Daten von Mitarbeitern, Daten die sich nicht oft ändern, bzw. deren Änderung periodisch geschieht. Diese Daten sind eindeutig versioniert. Auf diese Daten wird auch in der Regel nur lesend zugegriffen und meist werden diese Referenzen nur an Aktivitäten in der Anwendung mitgegeben um sich darauf zu beziehen.
Aktivitäts Orientierte Daten
Es gibt aber auch Daten die während der Benutzung der Anwendung erzeugt werden. Zum Beispiel das Erstellen eines Warenkorbes. Diese Daten sind exklusiv für den jeweiligen Benutzer und werden auch schreibend verändert und sollten dementsprechend auch in einer Transaktion manipuliert werden können.
Resource Orientierte Daten
Bei bestimmten Anwendungen werden eine gewisse Anzahl von Resourcen im System vorhanden sein, die es dann abzuarbeiten gilt. Eine Resource könnte zum Beispiel bei einem Flugbuchungssystem der Sitzplatz in einer speziellen Maschine sein. Hier ist der Umgang meist lesend und wenn geschrieben wird, weil der Sitz gebucht wird, so passiert das im Wissen das konkurrierende Zugriffe erfolgen können. Eine Resource ist meist Bestandteil mehrerer Transaktionen. Hier gibt es zusätzlich die Problematik ob ich diese exklusiv beim Bearbeiten sperren möchte oder das System im Falle der Flugbuchung Überbuchungen zulässt, also mehr eine relaxte Art mit der Resource umzugehen.
Diese drei Arten von Daten unterstützt Velocity. Was ist nun das besondere an einem verteilten Zwischenspeicher? Skalierbarkeit und Verfügbarkeit der Daten. Auf Server-Farmen ist der Einsatz von Caching nicht trivial. Was passiert bei Aktualisierungen von Referenzdaten, was passiert wenn ich auf Server A einen Warenkorb angelegt habe und ich auf Server C beim nächsten Request mir diesen anzeigen lassen möchte? Ein Roundtrip zur Datenbank nur um die Daten zwischen zu speichern? Genau in diesen Bereich kann Velocity helfen, um die Zugriffs-Last an den Daten-Backend zu verringern.
Velocity vereint mehrere physikalische Maschinen zu einem logischen Cache den ich in diesem Verbund einheitlich ansprechen kann. Hier gibt es drei Begriffe die es zu verstehen gilt.
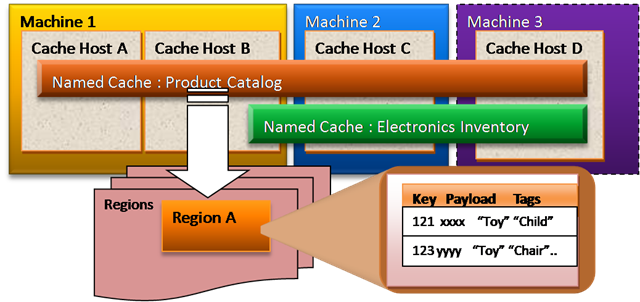
Named Cache
Durch die Zuweisung einer logischen Einheit enthält man einen Named Cache der über die gewünschte Anzahl von Maschinen einheitlich ist und nur über den Namen (deshalb Named Cache) angesprochen wird. Lege ich ein Objekt in den Cache, so weiß ich nicht wo dieses Objekt physikalisch landet, sondern ich übergebe es einfach dem Cache und Velocity macht den Rest. Der Named Cache kann auch noch über die Konfiguration einer Policy im Verhalten angepasst werden.
Region
Eine Region ist physikalisch einer Maschine zugeordnet. Regionen werden implizit angelegt durch Velocity, ich kann diese auch explizit anlegen. Objekte können Regionen zugewiesen werden um so auch komplette Graphen in eine physikalische Region zu packen. Velocity kann auch Daten aus einer Region auf andere Maschinen duplizieren und in sogenannten “Secondary Regions” aufbewahren, für den Fall das eine Maschine wegbricht.
Cache Item
Zu guter letzt gibt es noch das Cache Item. Das Cache Item enthält den eigentlichen Inhalt den man Speichern möchte, zusätzlich attributiert mit einem eindeutigen Key, wenn man möchte auch noch Tags und Angaben wie lange zum Beispiel das Item im Cache leben darf. Dies kann im übrigen unabhängig von der Definition des Named Cache sein.
Arbeiten mit Velocity
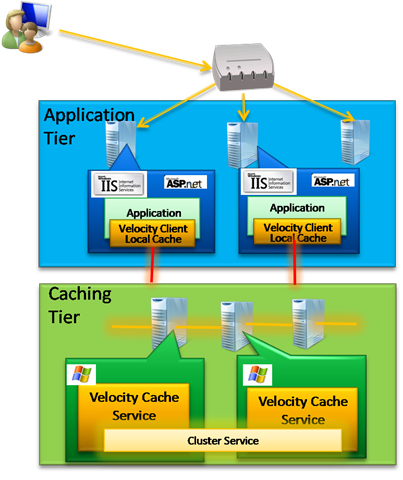
Wie funktioniert nun der Zugriff auf die Cache Objekte? Es gibt hier zum einen ein Velocity Client der dafür sorgt das über die Routing Tabelle auf die richtigen Inhalte im verteilten Zwischenspeicher zugegriffen wird, zum anderen gibt es den Velocity Service der dafür verantwortlich ist mit den anderen Diensten innerhalb des Clusters zu kommunizieren. Eine grobe Übersicht der Architektur gibt das folgende Schaubild:
Auf der Basta habe ich in meinem Velocity Vortrag eine Demo gezeigt, aber ich habe ganz vergessen zu zeigen wie der Quellcode aussieht um Objekte in den Cache zu legen. Vielleicht habe ich es unbewußt weggelassen weil die API wirklich sehr einfach gestrickt ist.
string text = "Bitte zwischenspeichern!";

CacheFactory cacheFactory = new CacheFactory();
Cache cache = cacheFactory.GetCache();

// Objekt in Cache Speichern
CacheItemVersion item = cache.Add("EindeutigerKey", text );

// Objekt wieder aus dem Cache lesen
item = ( string ) cache.Get( "EindeutigerKey" );
Die API verfügt zum arbeiten mit den Cache Objekten die Aufrufe, Add, Get, Put und Remove. Daneben hat man noch die Möglichkeit nach Tags zu suchen und komplette Regionen und Listen zu enumerieren. Das war es schon.
Velocity ist momentan als CTP1 verfügbar. Im CTP1 sind noch nicht alle Features implementiert die im Release verfügbar sein sollen, unter anderem die Verfügbarkeits-Funktionalität. Diese werden erst mit dem CTP2 kommen. Microsoft würde sich über Feedback freuen.
Links zum Thema